

两个图层均支持演示机房及导入的文件。从您的系统实时获取 token 与功率计数需要实时对接,该功能已列入路线图。
IT 图层:设备 · Token
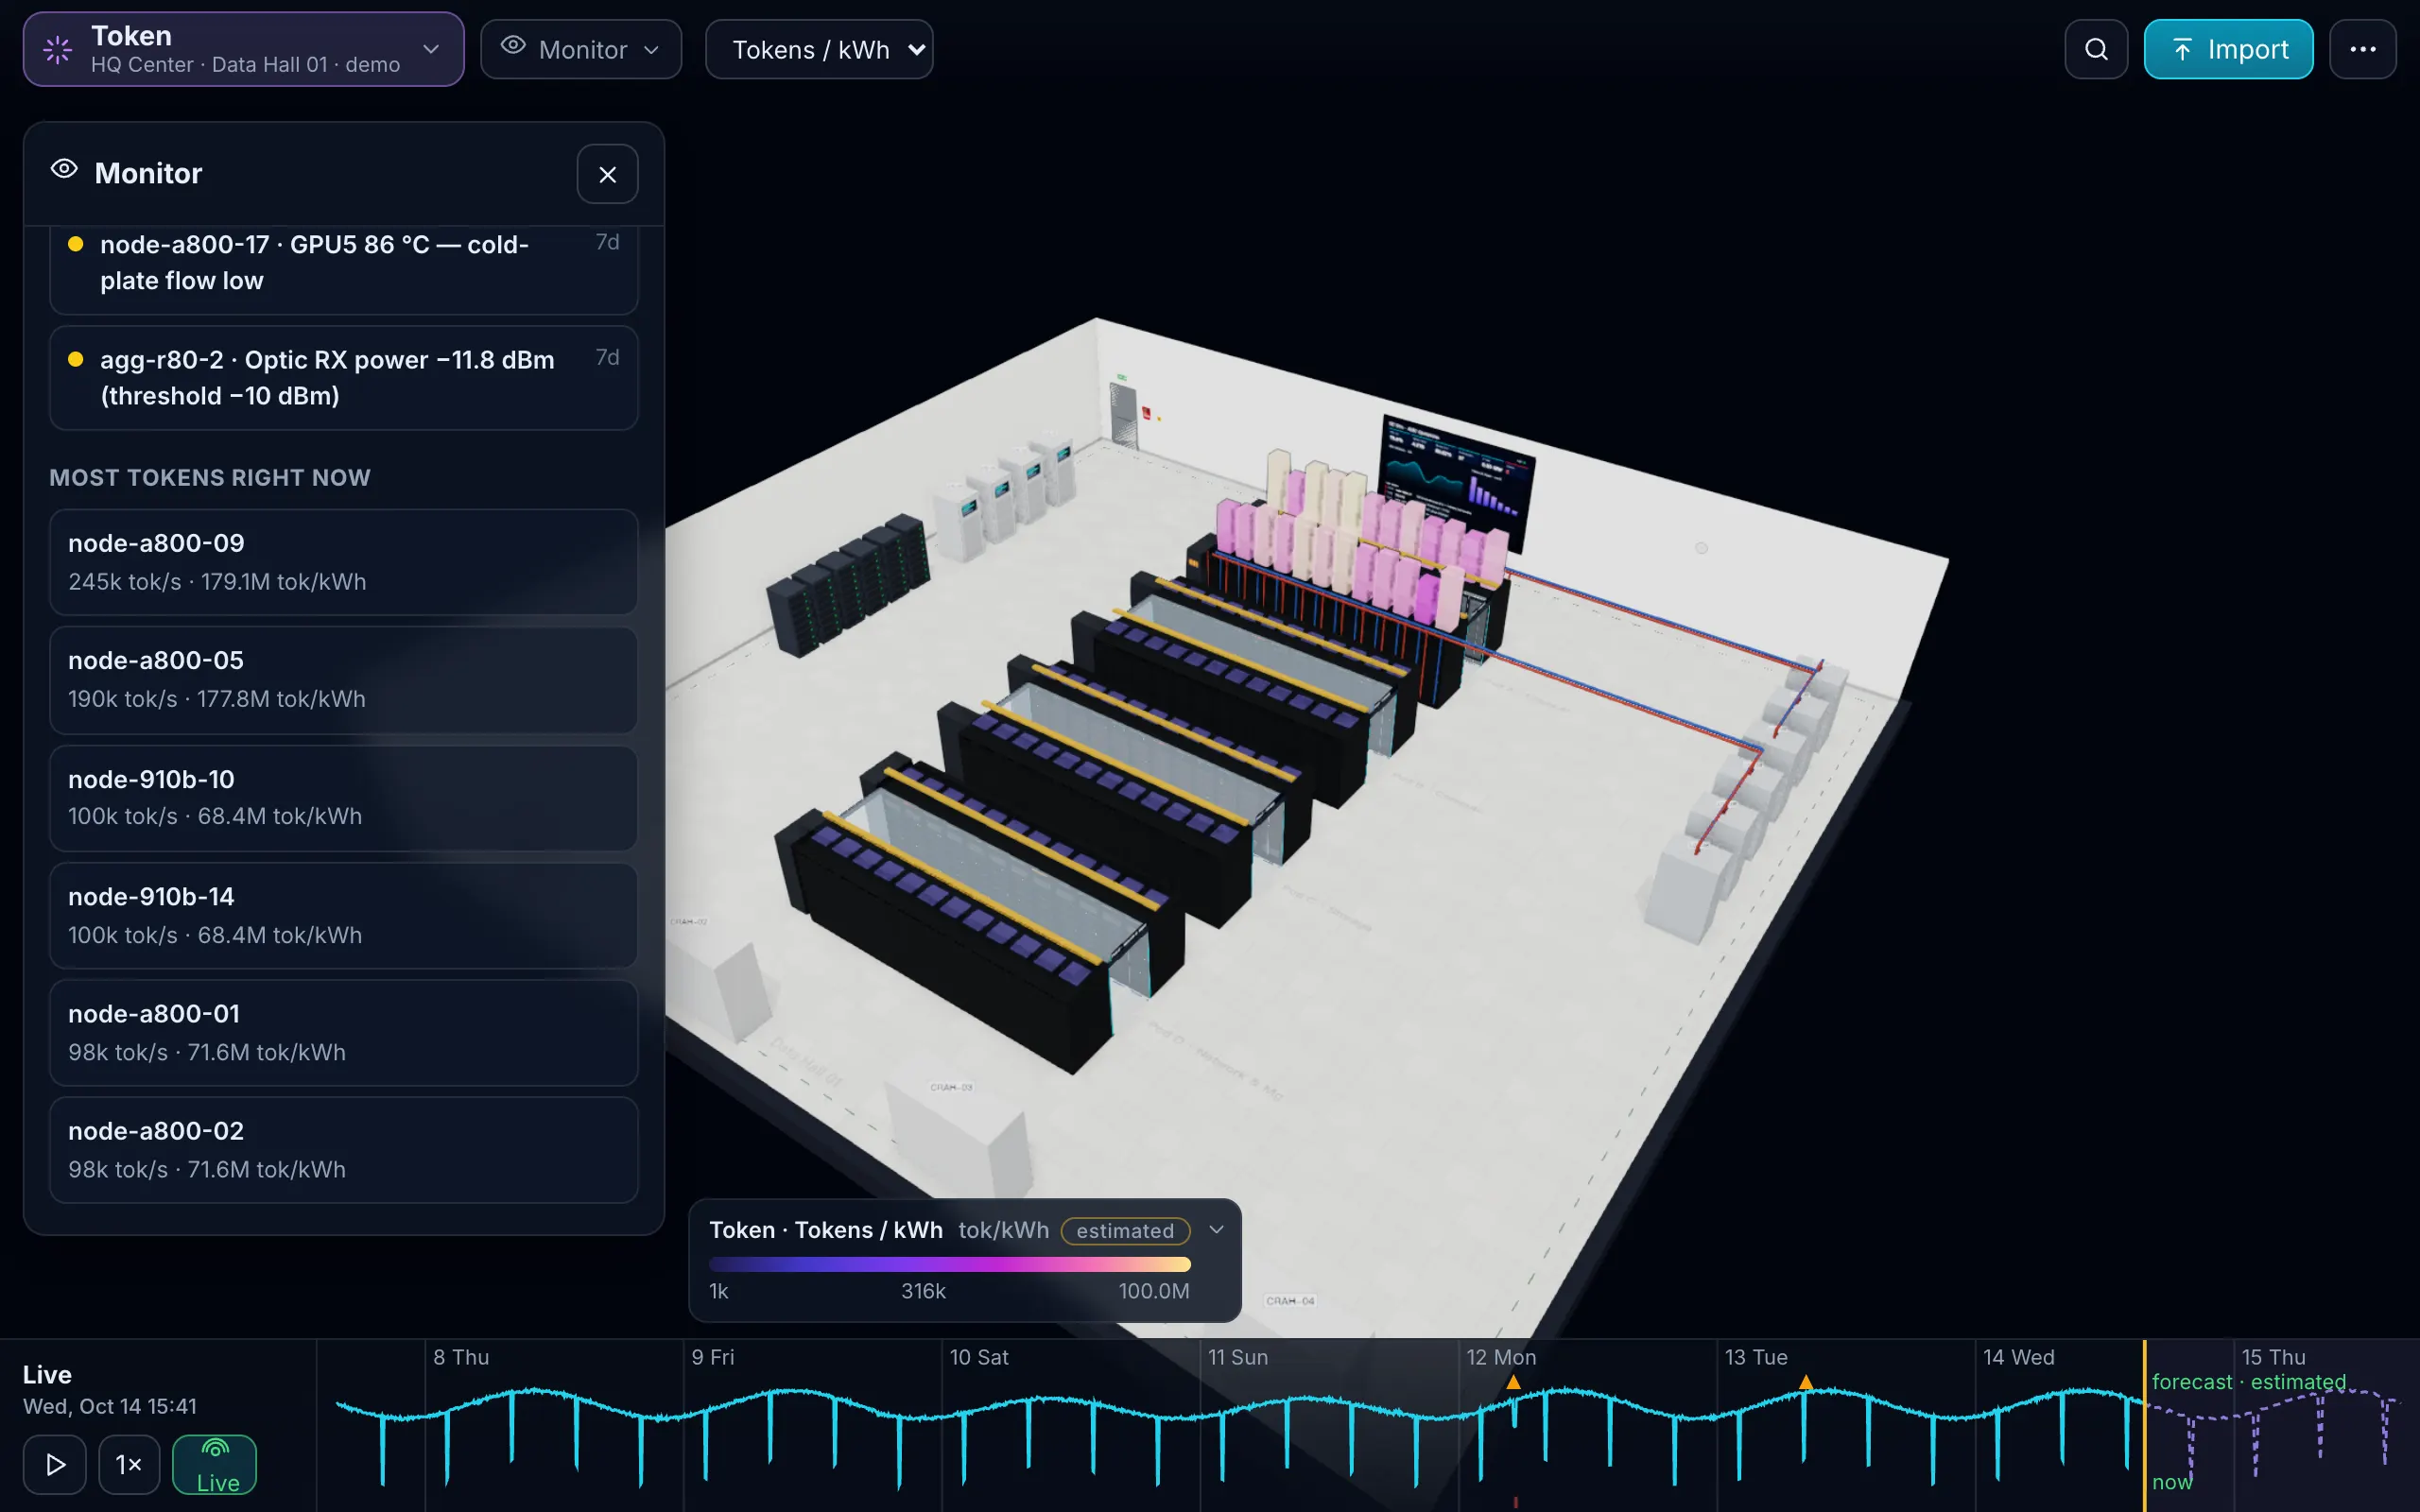
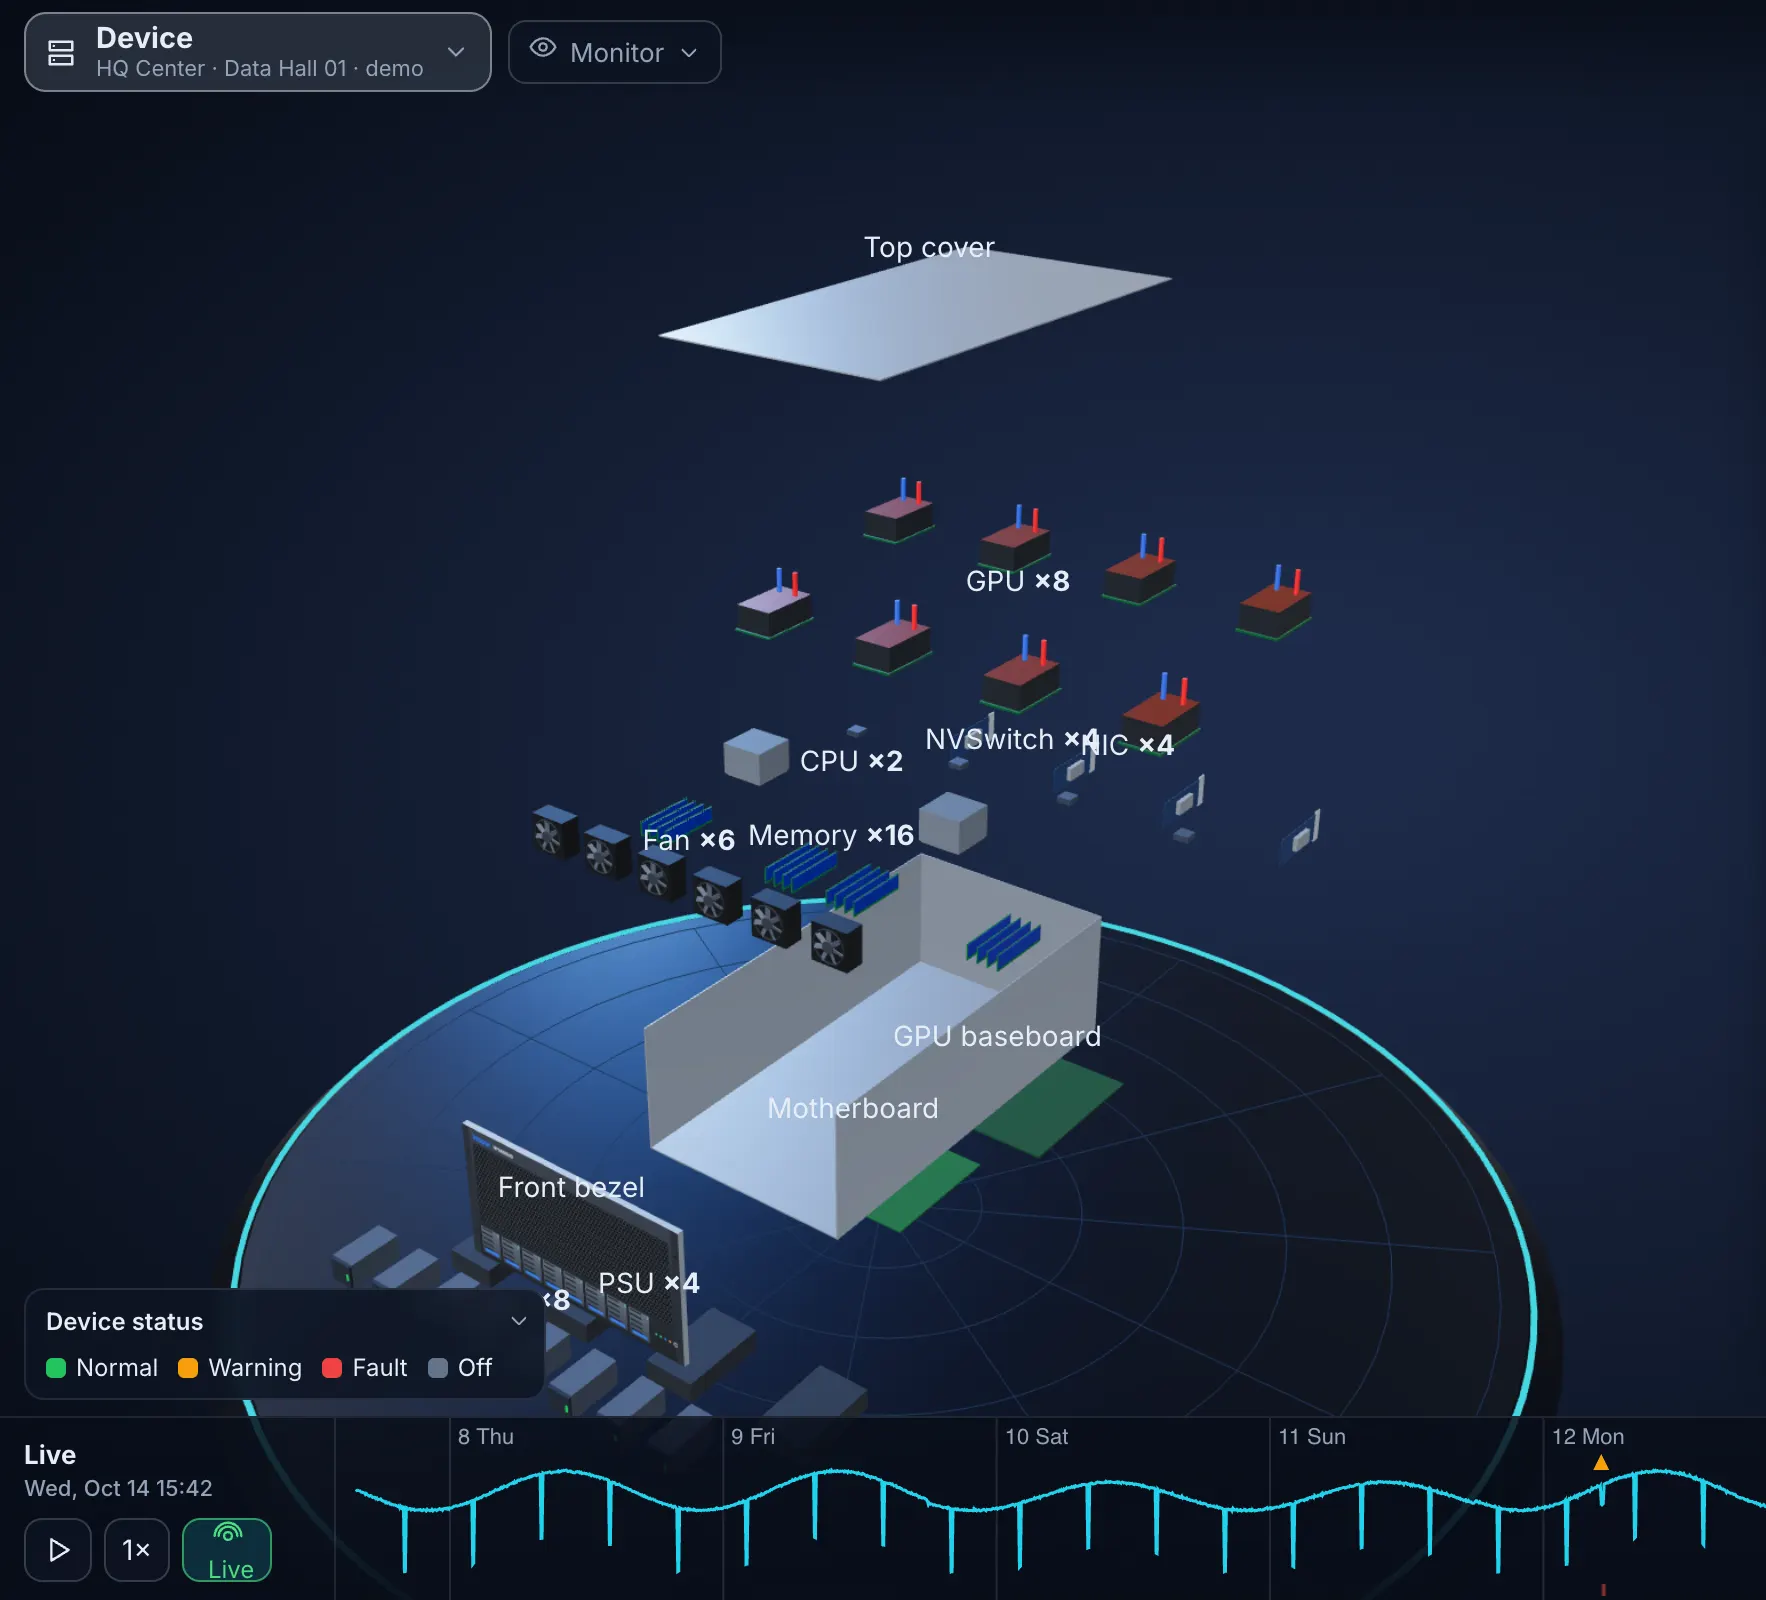
IT 图层关注设备本身及其承载的业务。设备图层显示每台服务器、交换机、存储节点和 PDU 的状态、故障与部件,可在机柜中打开并拆解。Token 图层显示 GPU 节点的产出:单台服务器的每秒 token 数、单个机柜的每千瓦时 token 数,以及一次故障造成的 token 损失。
设备(Device):“内部有哪些部件,哪些业务依赖它?”
呈现内容:每台设备的状态、故障与 LED。走到机柜前打开服务器,将其拆解至部件(PSU、风扇、内存条、硬盘、GPU);数据源提供时,同时显示各部件的数值。
故障推演:部件故障时,列出所在设备、其承载的业务(runs 列)与租户。12 个月内到期的维保在导入时予以标出。
数据来源:Devices 工作表(设备表:rack, u, model, name, role, height_u, power_cords, serial, owner, warranty_end, runs)。型号文本与设备库依次进行精确匹配、别名匹配、型号代码匹配和模糊匹配(例如“PE R740XD”可匹配到正确的服务器)。未知型号显示为待识别的通用方块。
设备库:涵盖服务器、GPU 节点、交换机、存储、PDU、UPS、制冷单元与 CDU(冷量分配单元),包含尺寸、重量、功耗、气流、冷却方式与部件树,依据公开规格书和手册构建,初始数据来自一个开源设备类型库。性能字段(核数与 TDP、GPU 吞吐、存储 IOPS、网络带宽)正在补充,以支持设计模式据此进行选型。
Token:“哪台服务器 token 产出最高,能耗代价多大?”
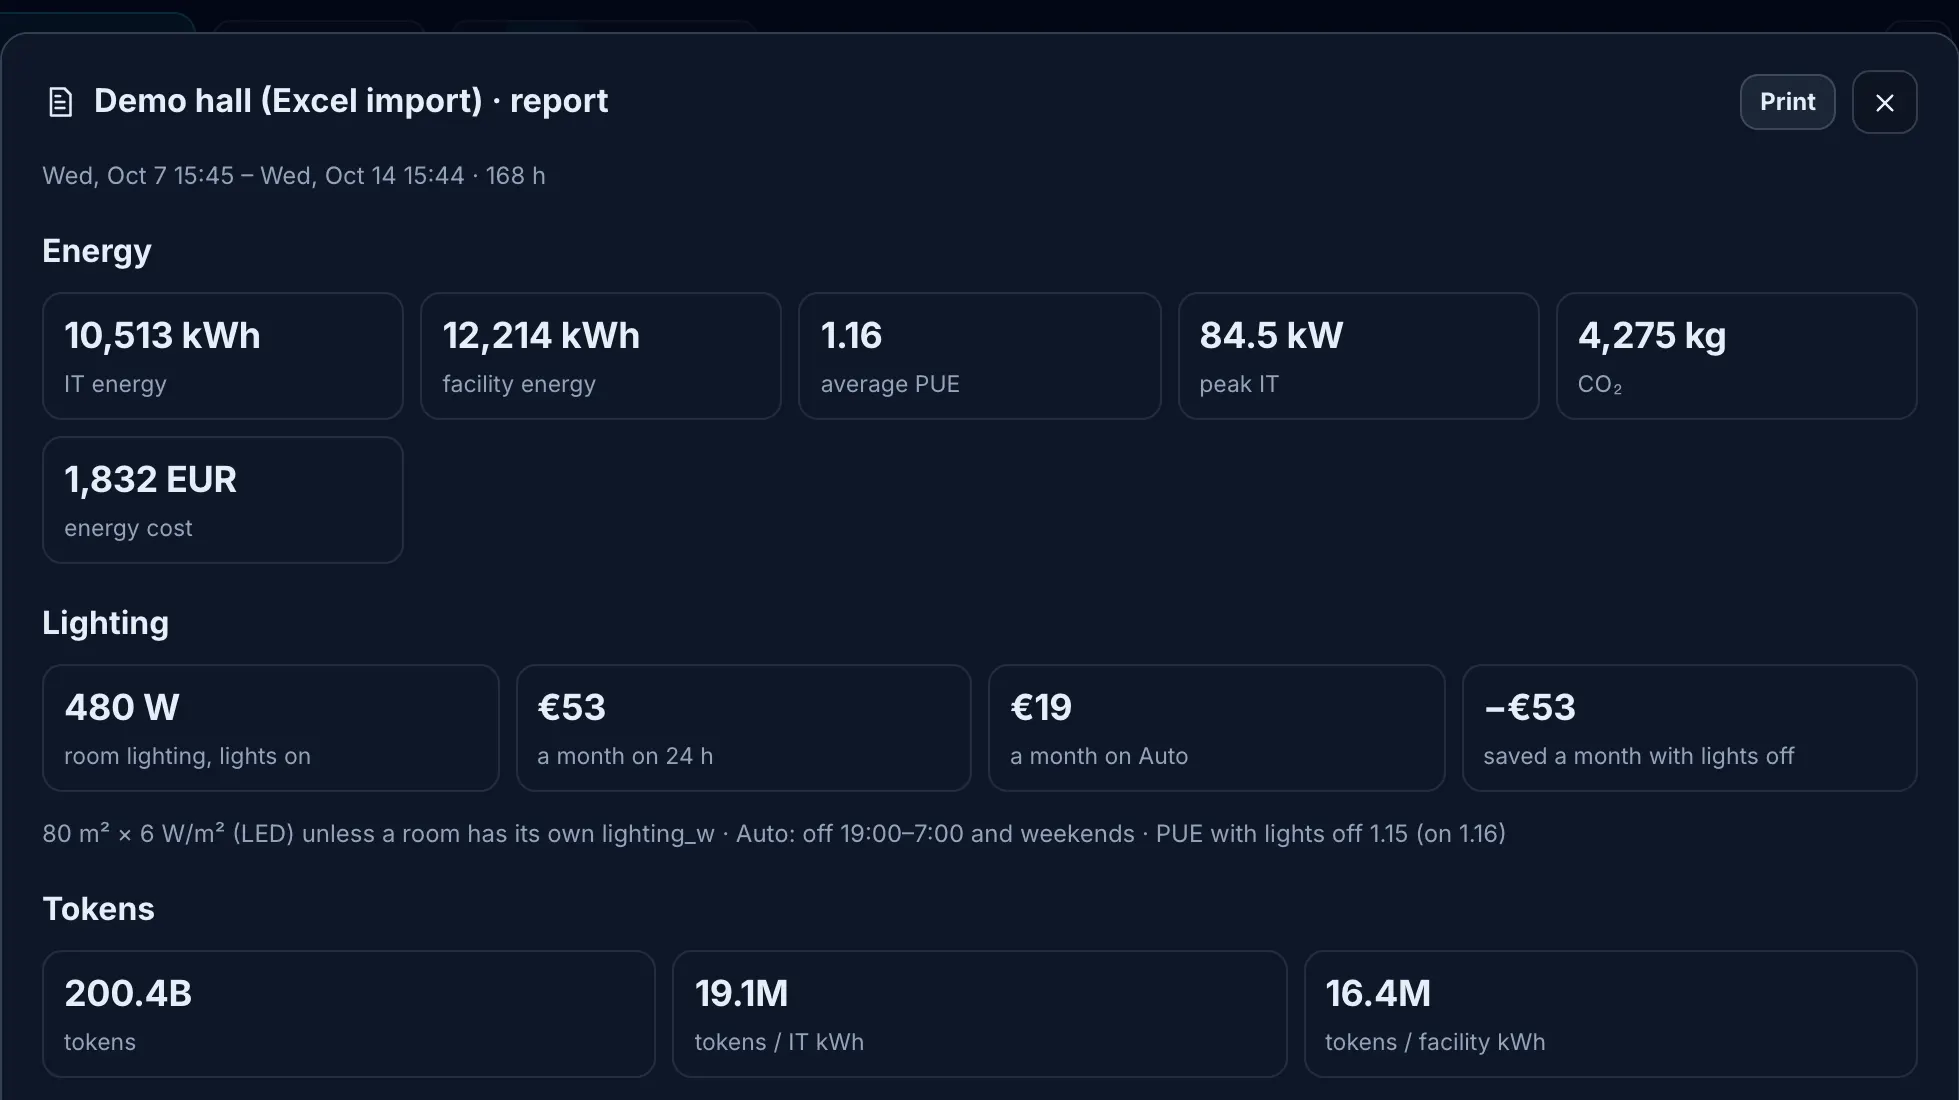
呈现内容:GPU 节点上的每秒 token 数柱状图,全机房以颜色表示的每千瓦时 token 数,监控模式(Monitor)中的 token 产出排行,以及报告模式(Report)中按业务、租户、模型和服务器统计的 token。
指标定义:每千瓦时 token 数 = token 产出量 ÷ 服务器(或机柜,含其分摊的设施能耗)消耗的电能。该指标将 AI 机房的产出与电费直接关联,可按服务器、机柜或租户计算。能耗一侧为模型估算而非计量值时,标注为估算。
故障推演:每个场景均报告 token 损失。令一路供电故障、停止一台制冷单元或模拟一处漏液,Token 图层即显示随之损失的服务能力。
当前数据来源:演示机房内置 token 计数,您也可以通过 Readings 工作表(监测数据表)导入 token 与功率历史数据。来自推理服务栈指标与 GPU 遥测的实时数据经采集代理(Agent)的采集器接入;采集器已开发完成,尚未在实际运行的系统上测试(路线图)。
在多数 AI 机房中,每千瓦时 token 数仍依靠表格人工计算:功率取自一个仪表盘,token 取自另一个。将两者汇聚到同一机柜后,两台服务器、两个机柜或两个租户之间的对比直接以颜色呈现。可使用每千瓦时 token 数计算器(英文),或阅读每千瓦时 token 数:AI 机房的核心指标(英文)。
成本分摊与容量
报告模式并列呈现按业务、租户、模型和服务器统计的 token、按您的电价计算的能耗与成本,以及每千瓦时 token 数,成本分摊因此直接形成报告,无需另行制表。估算值均有标注。
本图层所用的开放设备数据
导入型号时自动补全尺寸、重量、功率和气流的设备库为开放数据:以下类别共 127 个型号,含空载、典型和最大功率(W)、U 数、重量、端口及注明日期的目录价,并标注数据来源。
计算每千瓦时 token 数需要哪些数据?
需要推理服务栈提供的 token 计数,以及同一台服务器的功率读数。目前两者均可作为历史数据通过 Readings 工作表导入;通过实时对接采集已列入路线图。
是否同时适用于训练和推理?
token 计数来自推理服务栈。训练任务显示 GPU 利用率与功率;训练场景下的每千瓦时 token 数需要任务级计数,该功能已列入路线图。
能否识别空闲 GPU?
监控模式(Monitor)显示各节点的利用率与每秒 token 数;按空闲程度排序的 GPU 报告已列入路线图。
设备库是否完整?
任何设备库都无法做到完整。已知型号自动补全;未知型号按您填写的高度显示为通用方块,并标记为“待识别”。提供规格书后即可补充入库。
能否查看部件级监测数据?
数据源提供时,数值显示在拆解后设备内部的对应部件上:目前来自导入的监测数据,实时对接上线后来自对接数据源。
适合 10 个机柜机房的定价
设计版(Design)
$490 起 按项目一次性收费
用于规划机房或新增机柜列;每个项目使用期三个月。AI 设计助手上线后包含在内,不另收费。
监测版(Monitor)
$5 每机柜每月,最低 $49
运行中机房的数字孪生,含故障推演与报表。
合作伙伴
30 % 利润空间
面向系统集成商、托管服务商(MSP)和咨询顾问。
一个 Excel 文件,即可 3D 呈现您的机房。
下载导入模板(v1.4,11 张工作表,仅 Devices 为必填)及演示机房的填写示例。无需填写表单,无需提供邮箱,文件不含宏。
填写 Devices 工作表,随演示预约一并发送;我们将在演示通话中现场导入。 各工作表说明