

Beide Ebenen laufen in den Demo-Räumen und mit importierten Dateien. Live-Zähler für Token und Leistung aus Ihren Systemen brauchen Connectors, die auf der Roadmap stehen.
IT-Ebenen: Gerät · Token
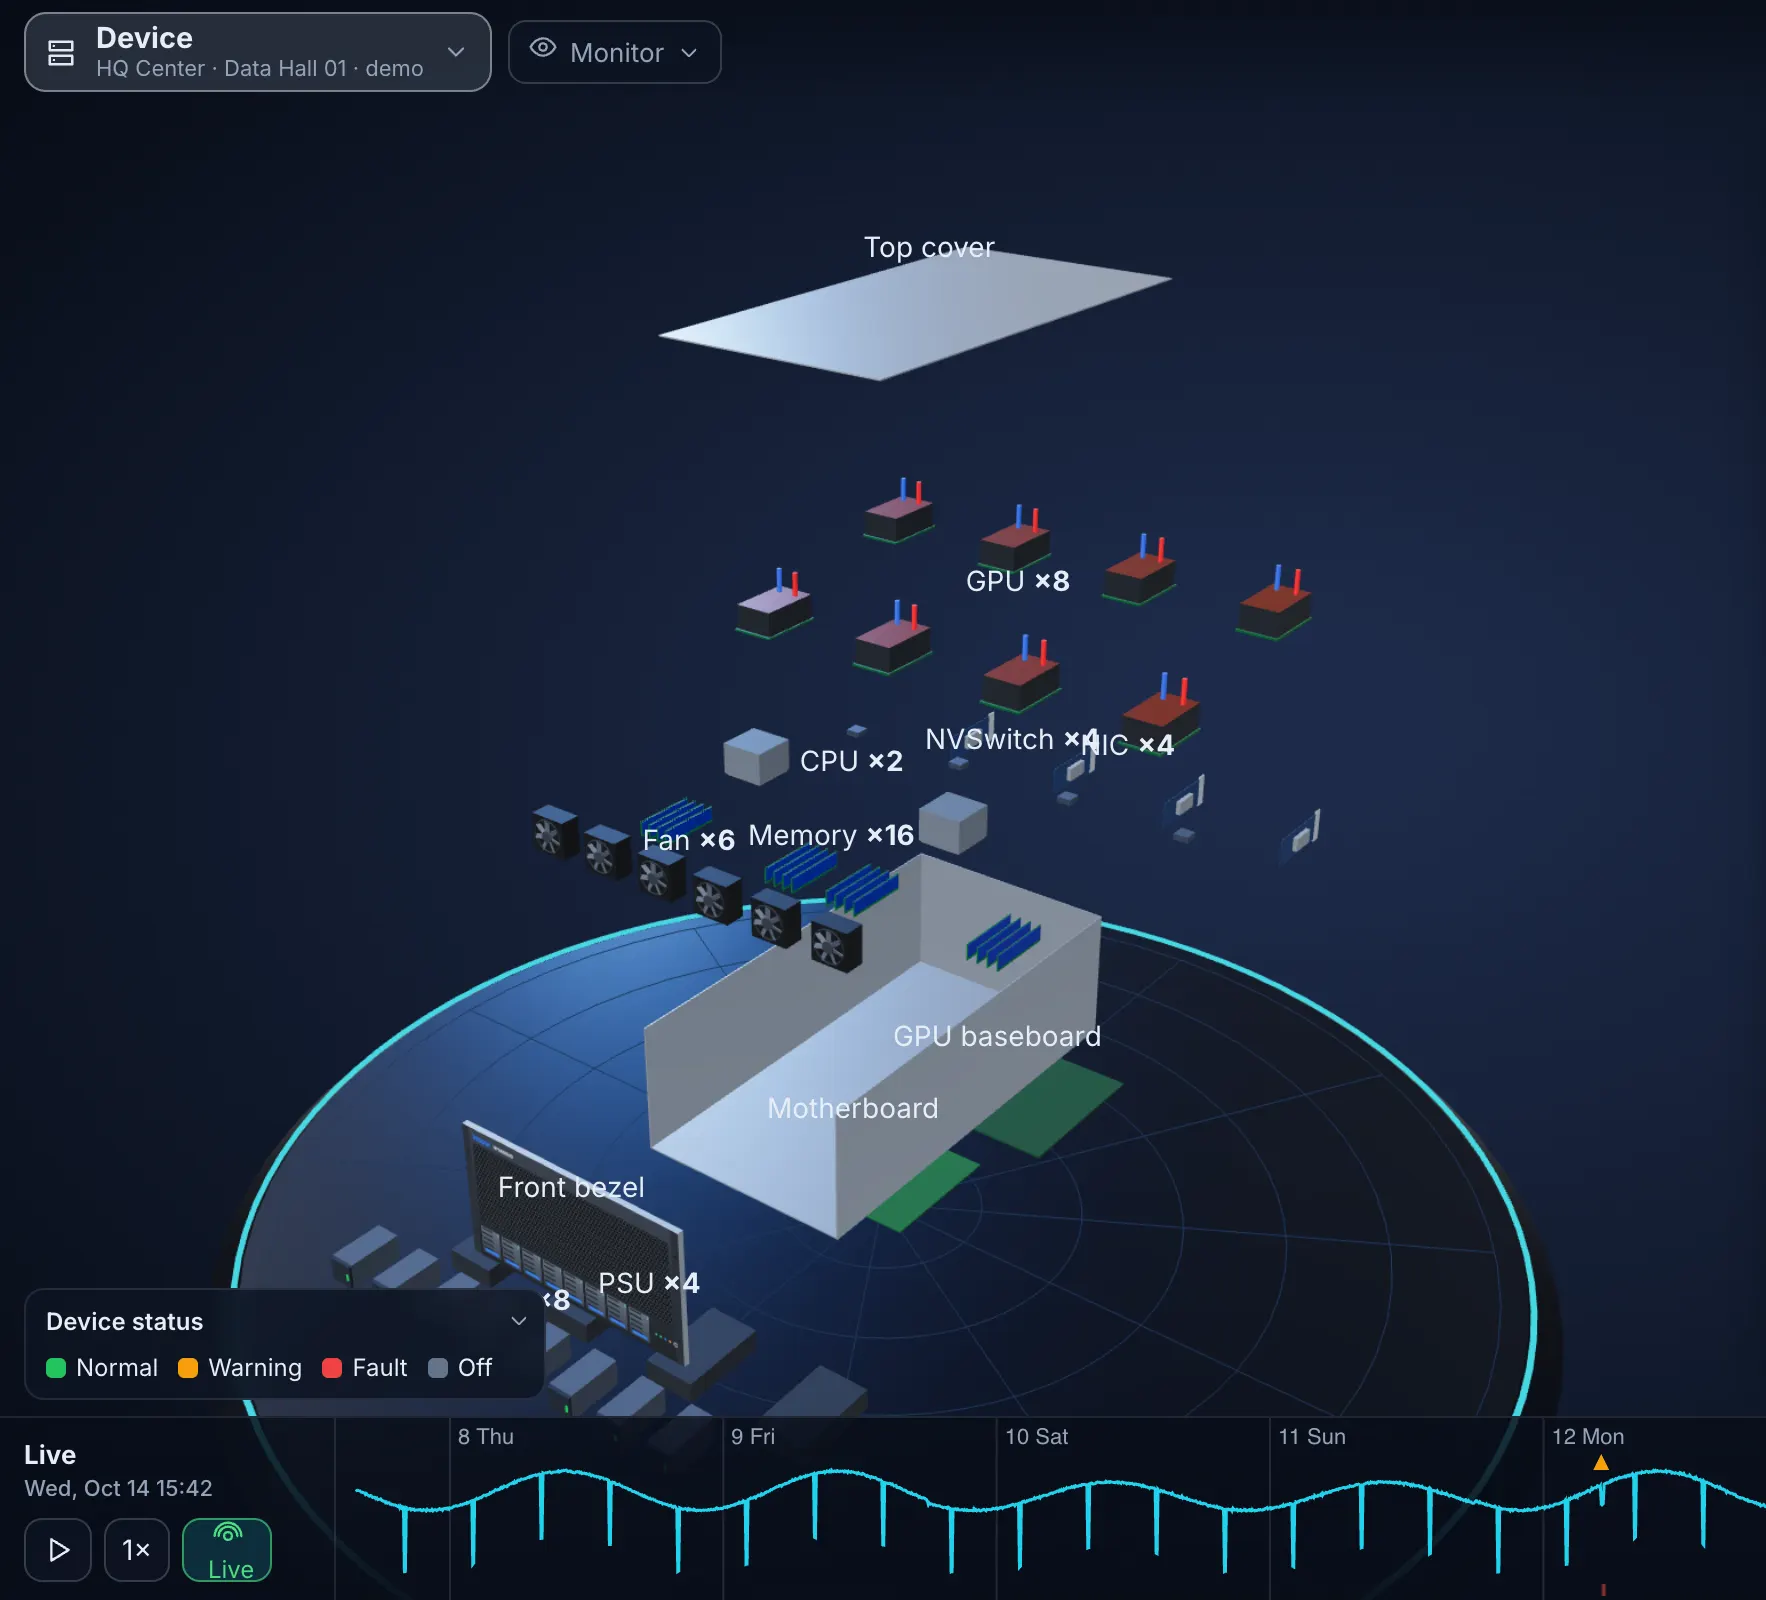
Bei den IT-Ebenen geht es um die Hardware und die Arbeit, die darauf läuft. Gerät zeigt jeden Server, Switch, Storage-Knoten und jede PDU mit Status, Fehlern und Bauteilen; öffnen Sie ein Gerät im Rack und nehmen Sie es auseinander. Token zeigt, was die GPU-Knoten produzieren: Token pro Sekunde je Server und Token pro kWh je Rack, und wie viele Token ein Ausfall kosten würde.
Gerät: „Öffnen Sie es. Was steckt drin, und wer hängt davon ab?“
Was Sie sehen: Status, Fehler und LEDs an jedem Gerät. Gehen Sie zu einem Rack, öffnen Sie einen Server und zerlegen Sie ihn in seine Teile (Netzteile, Lüfter, DIMMs, Laufwerke, GPUs), mit Werten je Komponente, wo eine Quelle sie liefert.
Was-wäre-wenn: Ein Fehler an einem Bauteil listet das Gerät, seine Workloads (Spalte runs) und seine Mandanten. Eine Garantie, die innerhalb von 12 Monaten endet, wird beim Import markiert.
Aus der Tabelle: Devices (rack, u, model, name, role, height_u, power_cords, serial, owner, warranty_end, runs). Der Modelltext wird mit dem Gerätekatalog abgeglichen (exakt, Aliasse, Modellcodes, dann unscharf: „PE R740XD“ findet den richtigen Server). Unbekannte Modelle werden zu einfachen Quadern, die später identifiziert werden.
Der Katalog: Server, GPU-Knoten, Switches, Storage, PDUs, USVs, Kühlgeräte und CDUs mit Abmessungen, Gewicht, Leistungsaufnahme, Luftstrom, Kühlung und Bauteilbaum, aufgebaut aus öffentlichen Datenblättern und Handbüchern, mit einer offenen Gerätetyp-Bibliothek als Grundstock. Performance-Felder (Kerne und TDP, GPU-Durchsatz, Storage-IOPS, Netzwerkbandbreite) werden derzeit ergänzt, damit der Design-Modus damit dimensionieren kann.
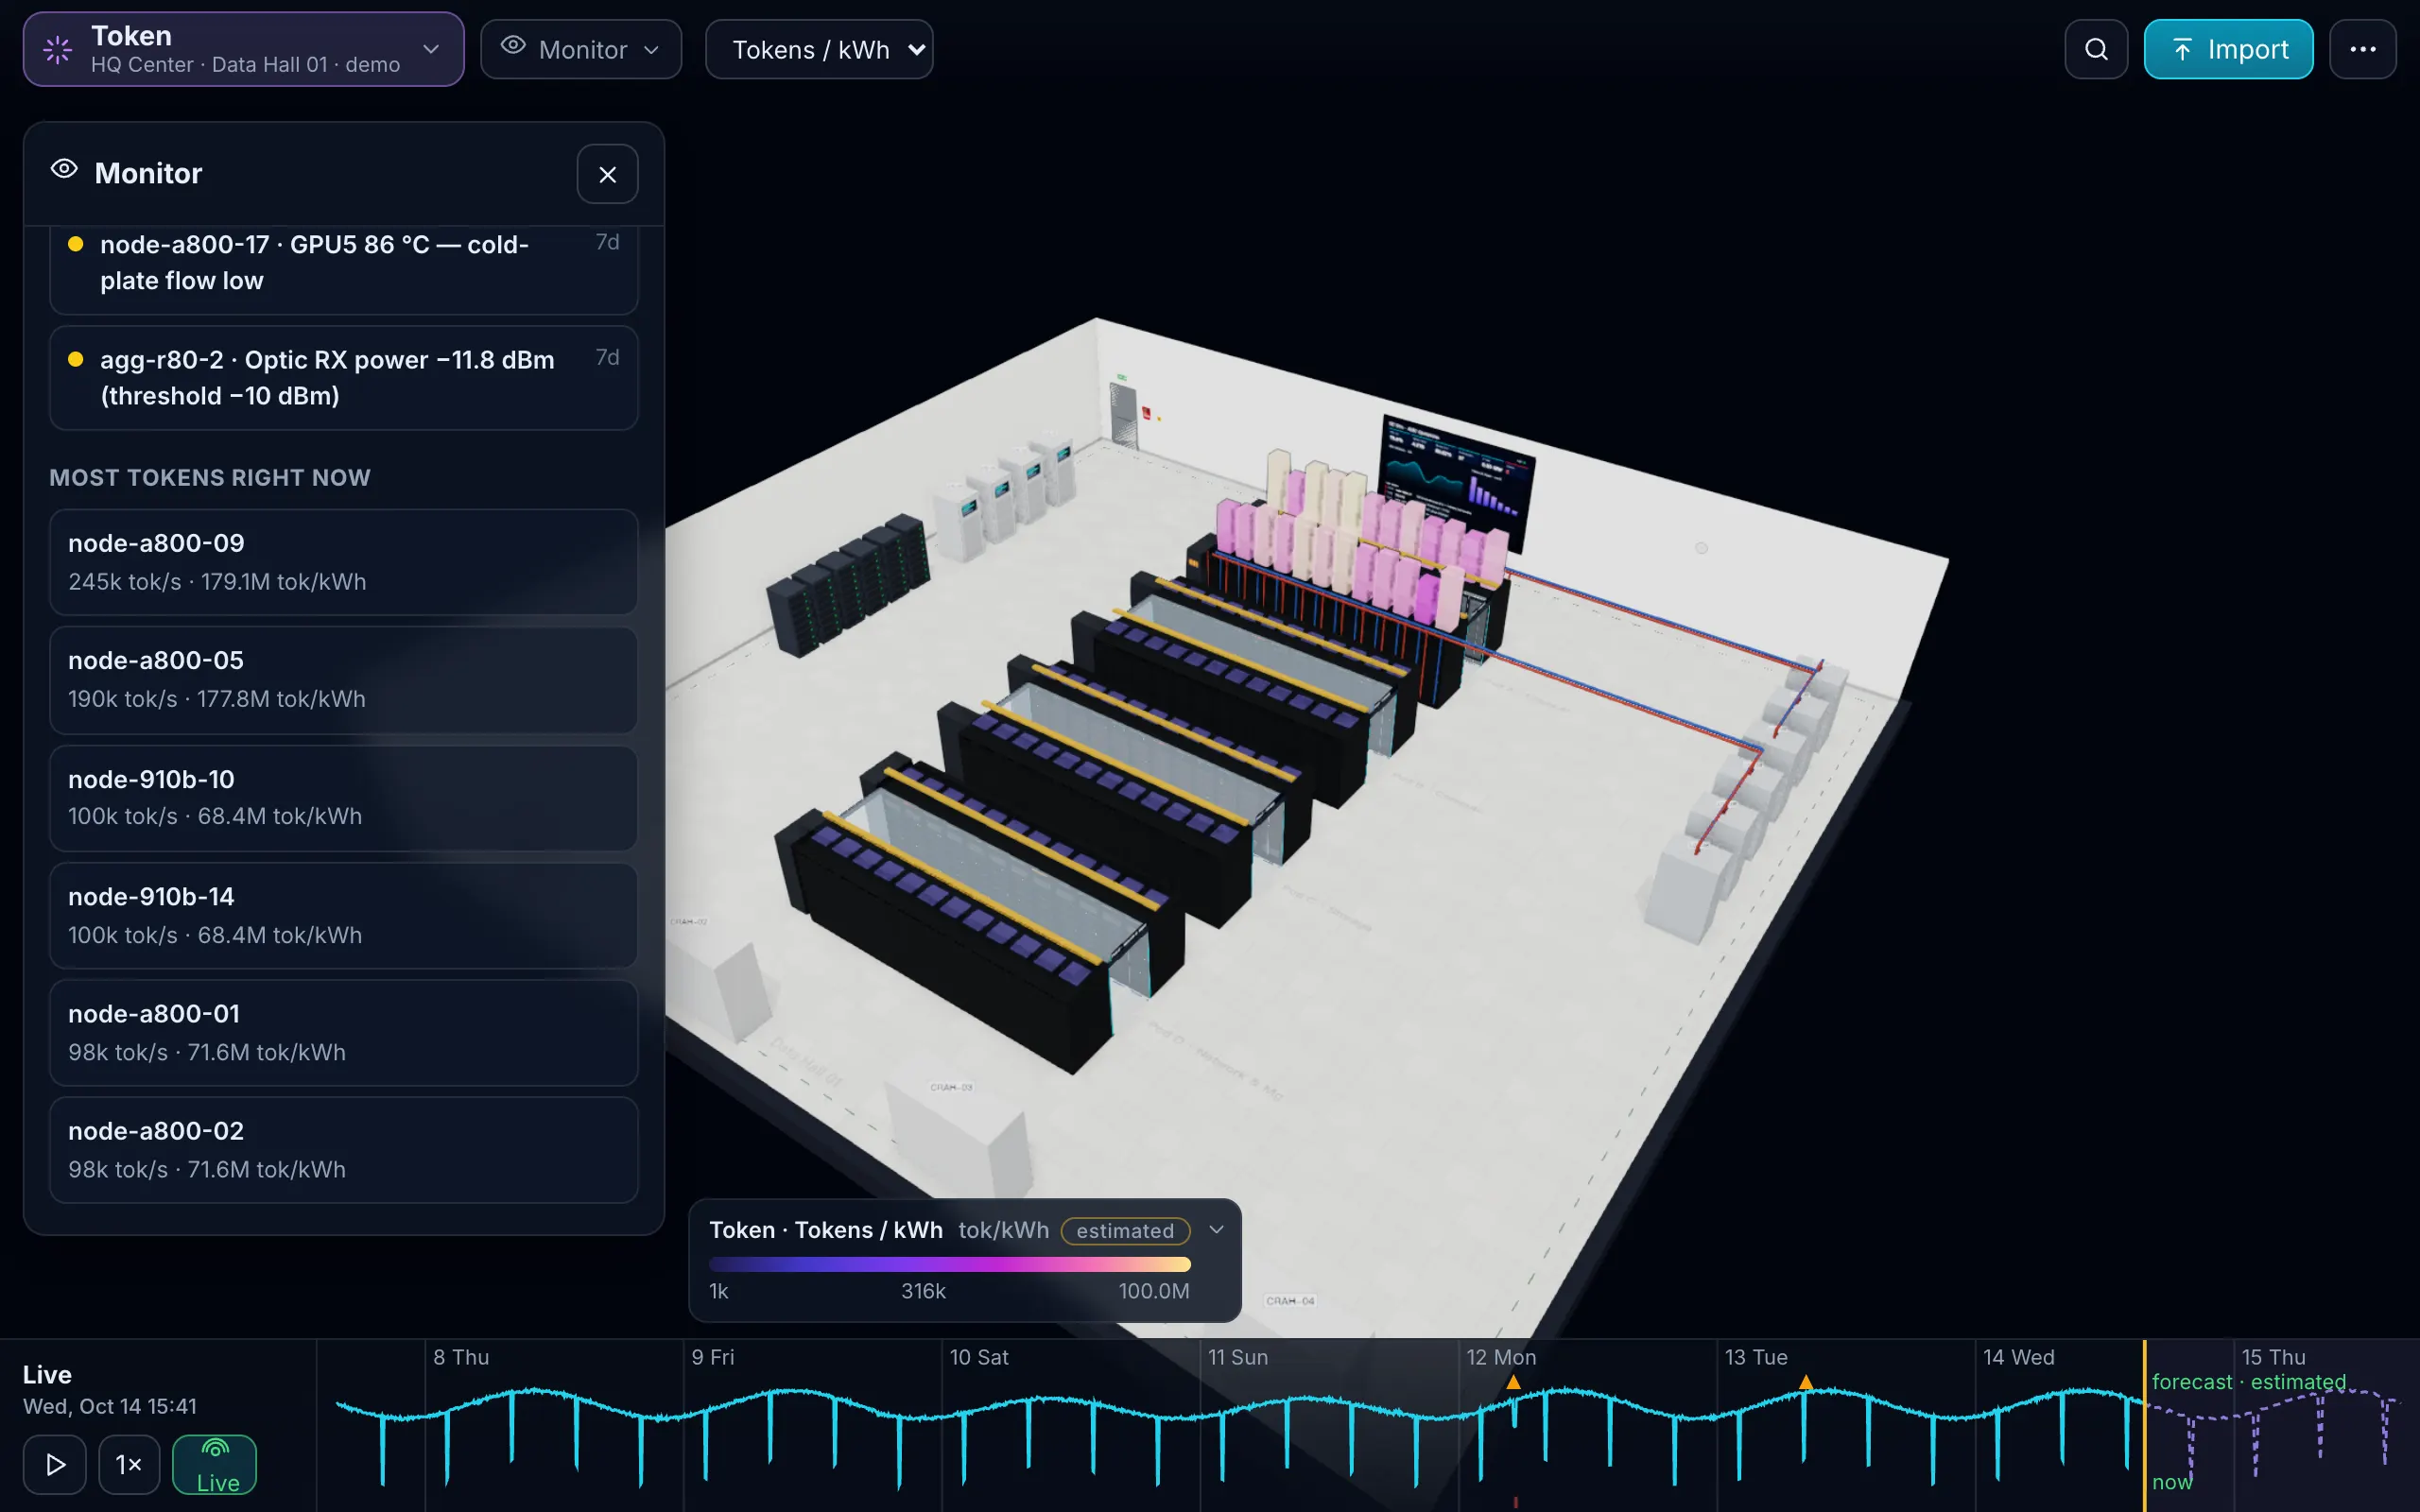
Token: „Welcher Server hat die meisten Token produziert, und zu welchen Energiekosten?“
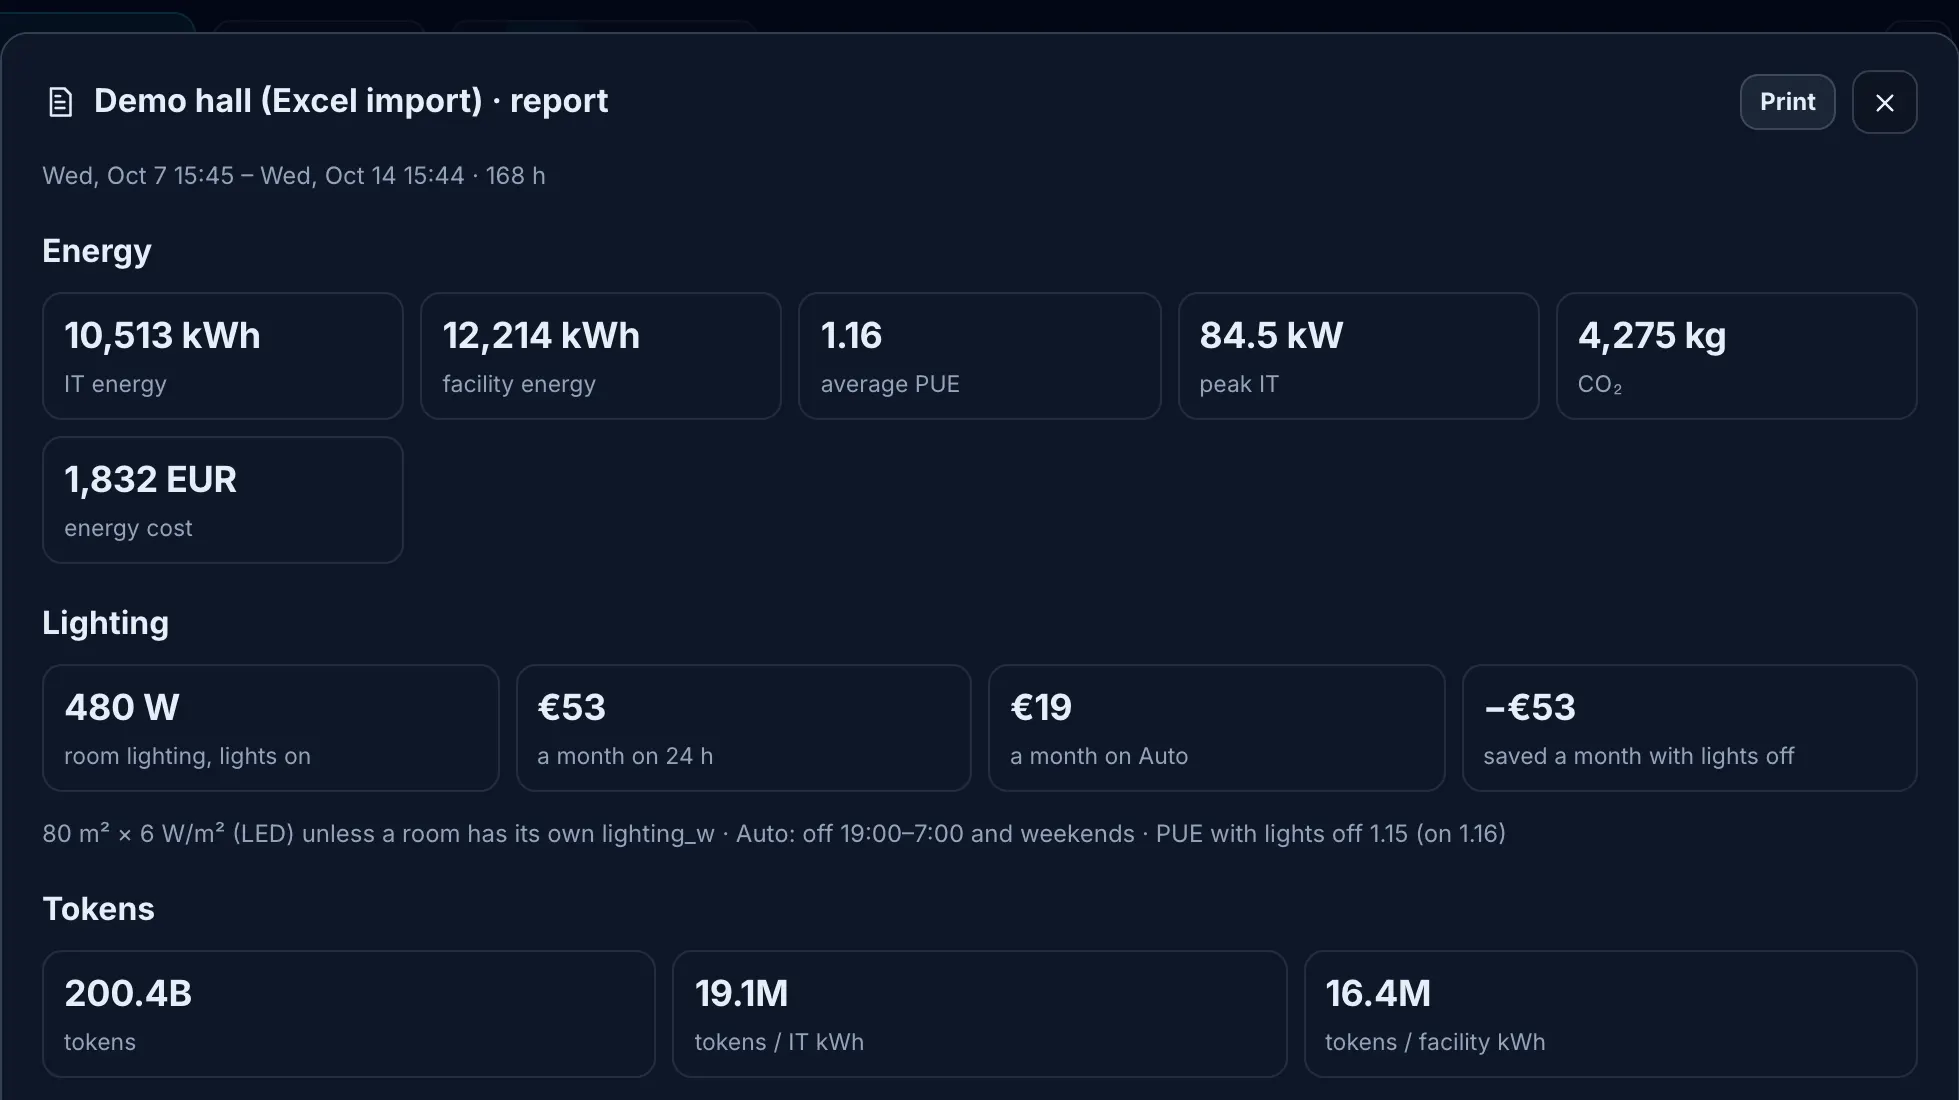
Was Sie sehen: Säulen für Token pro Sekunde auf GPU-Knoten, Token pro kWh als Farbe über den ganzen Raum, die stärksten Produzenten im Monitor, Token nach Workload, Mandant, Modell und Server im Report.
Die Kennzahl: Token pro kWh = erzeugte Token ÷ vom Server verbrauchte Energie (oder vom Rack, mit seinem Anteil an der Gesamtanlage). Es ist die eine Zahl, die den Output eines KI-Raums mit seiner Stromrechnung verbindet: je Server, je Rack, je Mandant. Wo die Energieseite eine Modellschätzung statt eines gemessenen Werts ist, ist sie als geschätzt gekennzeichnet.
Was-wäre-wenn: Jedes Szenario meldet verlorene Token. Lassen Sie eine Einspeisung ausfallen, stoppen Sie ein Kühlgerät, lösen Sie eine Leckage aus, und die Ebene Token zeigt, welche Serving-Kapazität wegfällt.
Daten heute: Die Demo-Räume enthalten Token-Zähler, und Sie können Token- und Leistungsverläufe über das Blatt Readings importieren. Live-Daten aus Serving-Stack-Metriken und GPU-Telemetrie kommen über die Collectors des Agenten, die entwickelt, aber noch nicht an Live-Systemen getestet sind (Roadmap).
In den meisten KI-Räumen ist Token pro kWh noch eine Tabellenkennzahl: Watt aus dem einen Dashboard, Token aus dem anderen. Bringen Sie beides aufs Rack, und der Vergleich zwischen zwei Servern, zwei Racks oder zwei Mandanten wird zu einer Farbe. Probieren Sie den Token-pro-kWh-Rechner (Englisch) aus oder lesen Sie Token pro kWh: die eine Kennzahl für einen KI-Raum (Englisch).
Kostenverrechnung und Kapazität
Der Report-Modus liefert Token nach Workload, Mandant, Modell und Server, Energie und Kosten zu Ihrem Tarif sowie Token pro kWh nebeneinander. So wird die Kostenverrechnung (Chargeback) zum Bericht statt zur Tabelle. Geschätzte Werte sind gekennzeichnet.
Offene Gerätedaten hinter dieser Ebene
Der Katalog, der beim Import eines Modells Größe, Gewicht, Leistung und Luftstrom ergänzt, ist offen: 127 Modelle in diesen Kategorien, mit Leerlauf-, typischer und maximaler Leistung in Watt, HE, Gewicht, Ports und datierten Listenpreisen, jeweils mit Quellenangabe.
- Servers39
- GPU servers19
- Rack-scale systems1
- AI accelerators2
- GPUs21
- CPUs6
- Storage arrays10
- Network switches29
Alle Gerätedaten (CSV und JSON, CC BY 4.0) (Englisch)
Was brauche ich für Token pro kWh?
Einen Token-Zähler aus Ihrem Serving-Stack und einen Leistungsmesswert für denselben Server. Heute können beide als Verlauf über das Blatt Readings kommen; die Live-Erfassung über Connectors steht auf der Roadmap.
Funktioniert das für Training ebenso wie für Inferenz?
Token-Zähler stammen aus Serving-Stacks. Trainingsjobs zeigen GPU-Auslastung und Leistungsaufnahme; Token pro kWh für das Training braucht einen Zähler auf Jobebene, der auf der Roadmap steht.
Zeigt DC Sim, welche GPUs im Leerlauf sind?
Monitor zeigt Auslastung und Token pro Sekunde je Knoten; ein sortierter Bericht über GPUs im Leerlauf steht auf der Roadmap.
Ist der Gerätekatalog vollständig?
Kein Katalog ist vollständig. Bekannte Modelle werden ergänzt; unbekannte erscheinen als einfache Quader mit der von Ihnen angegebenen Höhe, markiert mit „später identifizieren“. Schicken Sie uns ein Datenblatt, und das Modell wird aufgenommen.
Sehe ich Telemetrie auf Komponentenebene?
Wo eine Quelle sie liefert, am jeweiligen Bauteil im zerlegten Gerät: heute aus importierten Messwerten, aus Connectors, sobald diese verfügbar sind.
Preise, die zu einem Raum mit 10 Racks passen
Design
ab 490 $ pro Projekt, einmalig
Planen Sie einen Raum oder eine neue Rack-Reihe; drei Monate pro Projekt. Der KI-Planungsassistent kommt ohne Aufpreis dazu, sobald er verfügbar ist.
Monitor
5 $ pro Rack und Monat, mind. 49 $
Der Zwilling eines Raums im laufenden Betrieb, mit Was-wäre-wenn-Analysen und Berichten.
Partner
30 % Marge
Für Systemhäuser, MSPs und Berater.
Eine Excel-Datei. Ihr Raum in 3D.
Laden Sie die Import-Vorlage (v1.4, elf Tabellenblätter, nur das Blatt Devices ist Pflicht) und das ausgefüllte Beispiel aus unserer Demohalle herunter. Kein Formular, keine E-Mail-Adresse nötig, keine Makros in den Dateien.
Füllen Sie das Blatt Devices aus und senden Sie es mit Ihrer Anfrage für eine Vorführung; wir importieren es während des Gesprächs. Wozu jedes Blatt dient